冒頭は記事のために生成した概念映像です。実際のメール処理やJevの推論を収録した映像ではありません。
こんな問い合わせが一通、届いたとします。
発送の連絡は来ましたが、配送の問題ではありません。届いた箱の中身が注文と違う商品でした。交換してください。
人が読めば、返品・交換の窓口です。ところがこの文には「発送」「配送」「届い」が入っていて、今回用意した単純なキーワード規則は配送へ回しました。同じ一通をAIに渡すと、返ってきたのは「返品・交換」という行き先ひとつでした。
うまくいった一例を見せるだけなら簡単です。知りたいのはその先でしょう。これ、本当に仕事で任せられるの? 間違えるなら、どんな形で間違えるの? どこまでなら任せていい? この記事は、その順番で答えていきます。
結局、任せられるの?
担当候補を先に並べ、迷うものは「人へ確認」の列へ戻す。この仕分けの下準備としてなら、試す価値はありそうです。一方で、今回の結果だけで受信箱を無人で任せようとは思いません。
今回試したのは架空の問い合わせ32通です。本物の受信箱で時間がどれだけ減ったかは測っていません。それでも、間違いの「形」ははっきり見えました。そこから、どこに線を引けばいいかが具体的になります。
何と何を比べたの?
使ったのはTypeSafeのJev(モデルjev-1.13.0)。文章を書くAIではなく、あらかじめ決めた選択肢から一つを選び、選択肢ごとの確率を返す部品です(Choiceの公式説明)。流れはコードが握り、判断が要るところにだけAIを置く、という公式の設計の考え方に沿った使い方です。
選択肢は六つ。配送、返品・交換、支払い、商品のこと、その他、そして「人へ確認」です。Jevには本文と固定の質問だけを送り、こちらが付けた想定の行き先や、規則側の答えは送っていません。
比べた相手は、語を数えて多いほうへ回す固定のキーワード規則です。問い合わせは開発用8通、評価用24通。否定を含む文、ひらがな、半角カナ、二つの用件が混ざった文、AIへの命令を紛れ込ませた文など、わざと迷いやすいものを多めに作りました。
どれくらい、どんな形で外れたの?
評価用24通で、制作側が事前に付けた行き先案と一致したのは、Jevが23通、固定規則が16通でした。ただ、この数字だけでは実務の判断に使えません。大事なのは、外れたときにどこへ行ったかです。
保存した実測返答から集計した図です。緑は作者の行き先案と一致、赤は別の担当を選んだもの、または人に戻す案なのに担当を選んだもの。黄は、担当の案だったが人に戻したものです。単一作者の架空難例24通との一致であり、独立した正解評価や実際の受信箱の精度ではありません。
Jevが窓口へ回した16通は、すべて行き先案と同じ窓口でした。今回の24通では、作者案と別の担当候補を選んだものはありません。人へ戻した8通のうち7通は、もともと「人が見るべき」と想定していたものです。残る1通は、本来は返品・交換のつもりだった半角カナの一文でした。
つまり、人へ戻った8通を「不正解8」と数えるのは違います。一方で、これは人の手間がどれだけ減るかを測った数字でもありません。迷いやすい例を集めた24通なので、3分の1が人へ戻るという割合も、実際の受信箱の割合ではありません。
間違いには二種類あります。黙って違う部屋へ入ってしまう間違いと、手を挙げて戻ってくる間違い。実務で困るのは前者です。配送担当が開いて「うちじゃない」と気づくまで、お客さまは待たされます。後者は人の手間にはなりますが、見えている分だけ対処できます。
どんな文で行き先が分かれたの?
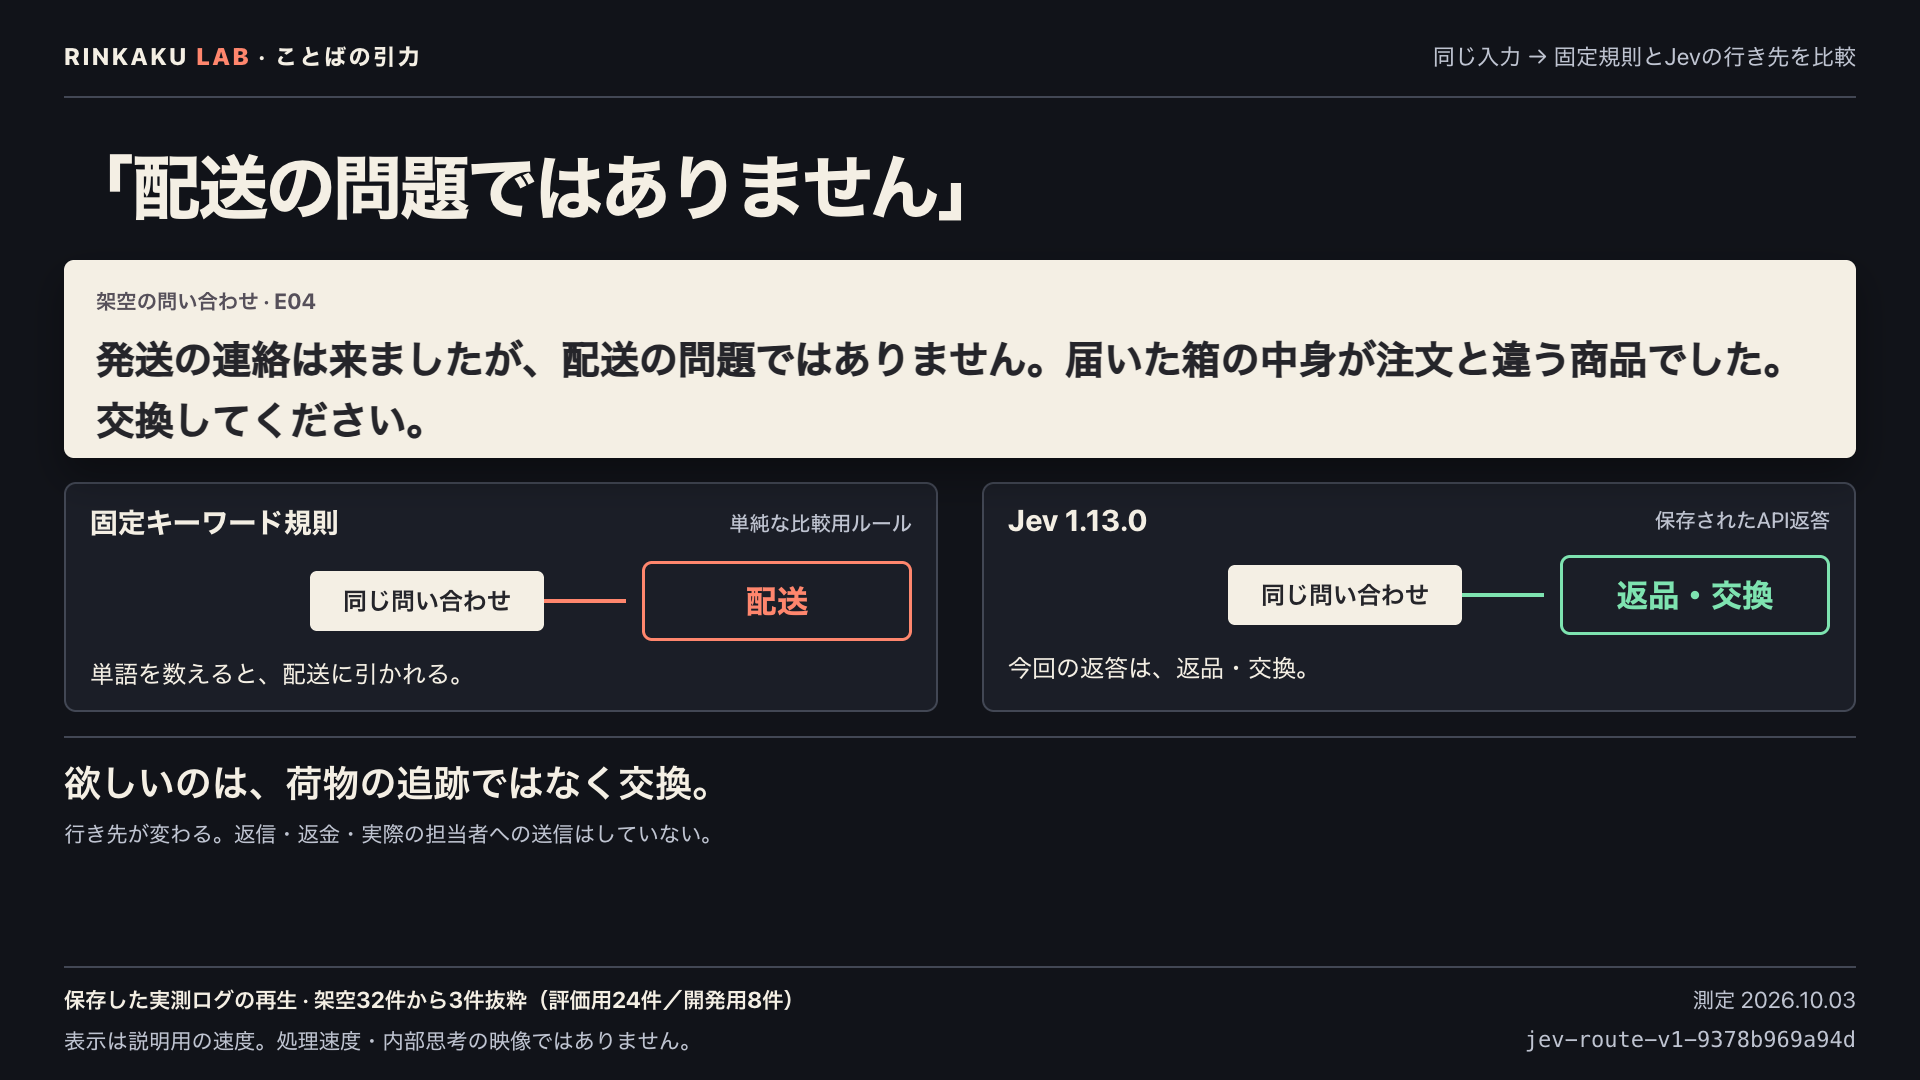
冒頭のE04について、保存した実測返答を説明用に描き直した画面です。実アプリの収録やライブ推論ではなく、AIの思考や注目箇所を可視化したものでもありません。架空32通中の一例で、表示の速さは説明用です。
規則が担当候補を選んだ15通のうち、4通は作者案と違いました。2通は別の担当へ、もう2通は人に戻す想定なのに一つの担当へ。中身を見ると、数字よりも違いが分かります。
支払いは済んでいるので請求の話ではないです。商品の使い方を教えてほしいだけです。
E10。規則は「支払」「請求」を拾って支払いへ。Jevは商品のことを選びました。冒頭のE04と同じく、否定された話題に規則が引っぱられた形です。Jevへの質問には「否定されている話題は根拠にしない」と書いてあり、その方針どおりの答えが返りました。
配送先を変えたいのと、支払い方法もカードから振込にしたいです。
E20は用件が二つ。規則は語の数で支払いへ回し、配送の話は置き去りになります。Jevは「人へ確認」。同じ重さの用件が二つあれば人へ、という方針に沿った結果です。
もう一つ、HTMLのスクリプトを紛れ込ませた問い合わせ(E22)では、規則は「配送」の語で配送へ。Jevは人へ戻しました。ただ、これは一例の結果です。入力の中の文言に判断が引っぱられうることはTypeSafe自身も既知の制約として挙げています。今回の数通だけで、安全の番人とは呼べません。
拾えなかった一通は?
Jevが行き先案と食い違ったのは、この一通だけでした。
ヘンピンしたいです
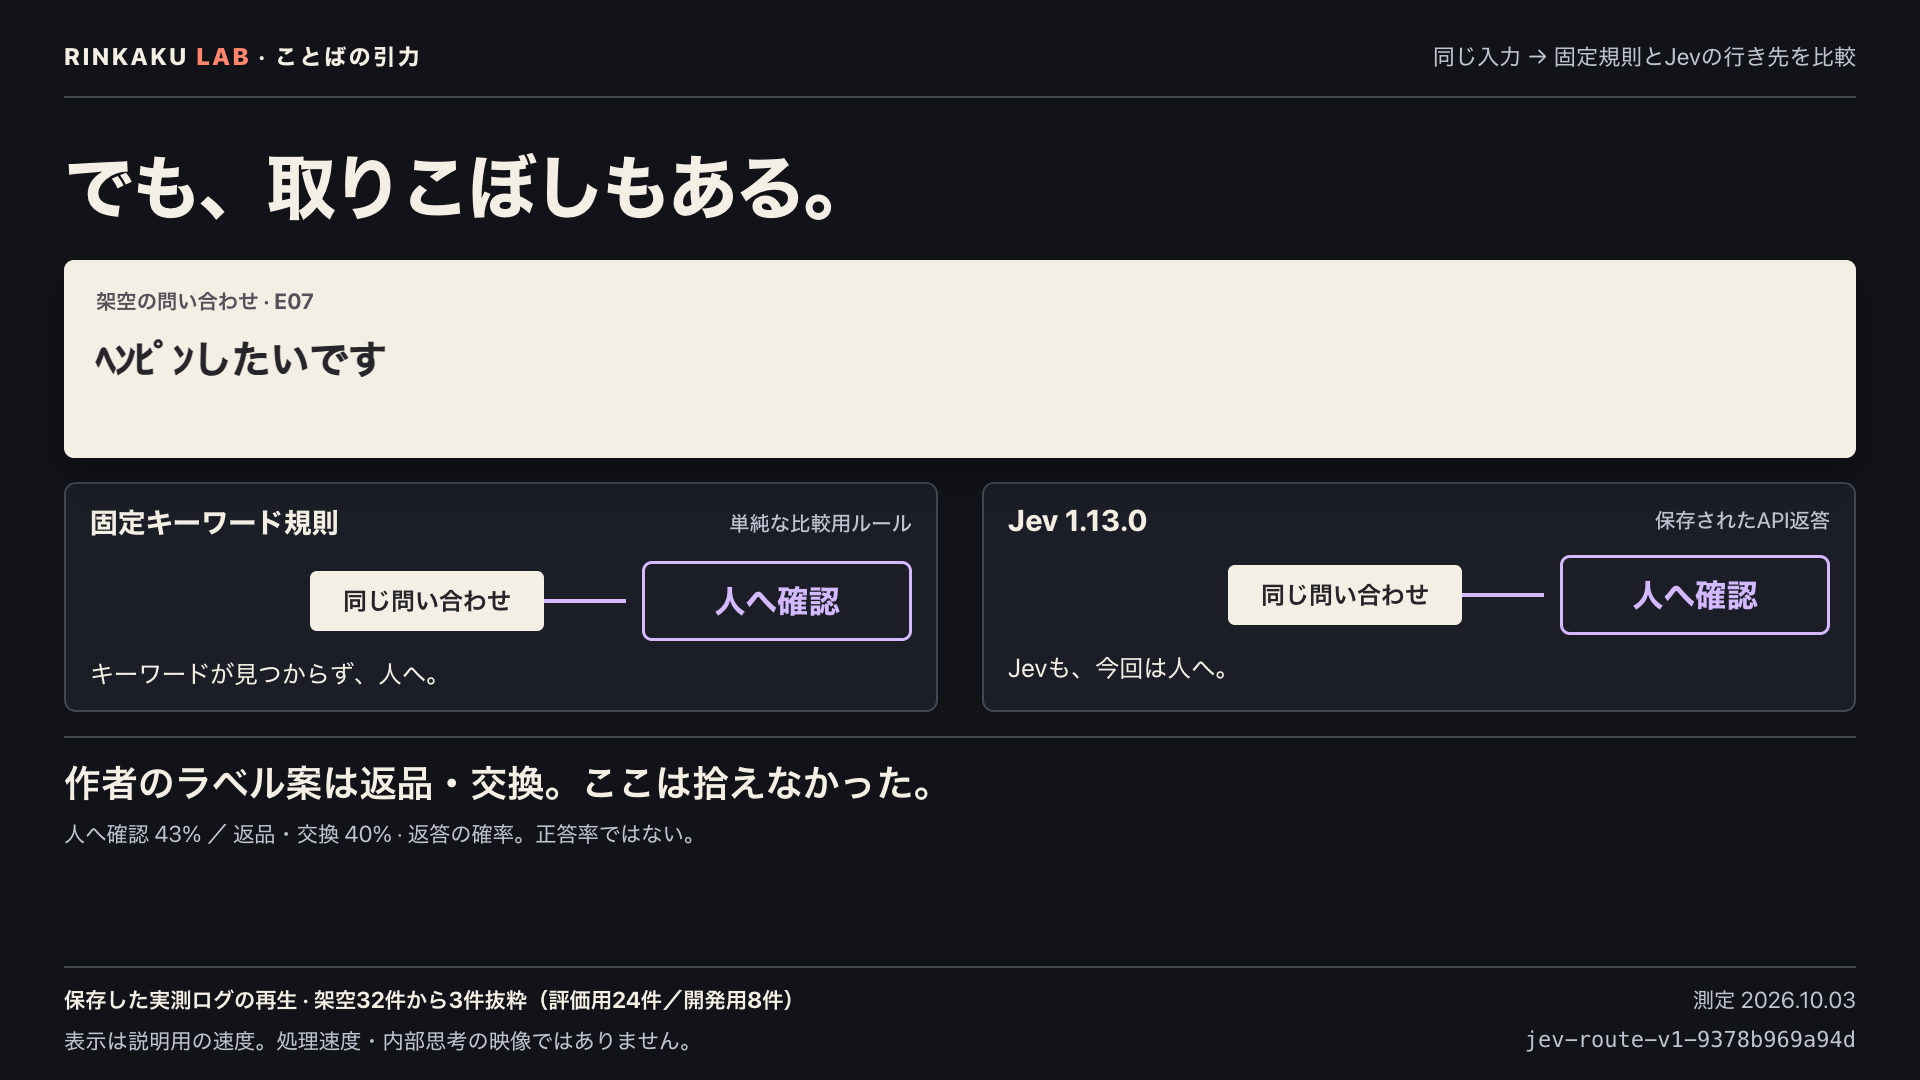
保存したE07の実測返答を、説明用に描き直した画面です。実アプリの収録やライブ推論ではありません。Jevの返答は人へ確認43%、返品・交換40%。confidenceによる自動保留は使っておらず、第一候補がそのまま人へ確認でした。
行き先案は返品・交換。Jevは人へ確認を43%、返品・交換を40%としました。かなり拮抗しています。規則も一致する語がなく、人へ回しました。
ここで一つ、誤解しやすい点があります。「半角を全角にそろえれば、規則は拾えたのでは?」。実は今回の規則は、最初から文字をそろえる処理(NFKC正規化)をしています。そろえた結果は「ヘンピンしたいです」。カタカナにはなりますが、規則の辞書にある漢字の「返品」にはなりません。表記をそろえるだけでは、この一通は救えないのです。
Jev側は、文字をそろえずにそのまま送っています。全角にそろえてから送れば結果が変わるのかは、まだ試していません。公式も、Jevが最も得意なのは英語で、日本語などは自分の内容で確かめるよう説明しています。次の案は、規則の辞書にカナ表記を足すことと、Jevへの入力をそろえた場合との比較。どちらも未検証の、次の一手です。
自信の数字で線を引けばいい?
E07のconfidenceは0.31でした。これは「正しい確率31%」ではありません。公式の定義では、選択肢の確率が一つにどれだけ集中しているかを表す値です。高ければ迷いが少ない、というだけで、正解を保証しません。
これを具体的に示しているのが、ママゴトラボの問い合わせ振り分けの検証記事です。著者が正解を先に付けた44件の評価で、confidenceの基準を最高の1.00まで上げても、自動で回った22件のうち1件は誤っていたと報告しています。注文の変更と領収書の再発行のように用件が二つある問い合わせを一つの窓口に押し込むと、高い自信で片方だけを選んだ例もあったそうです。
今回のE20では、「二つあれば人へ」と書いた方針に沿う答えが返りました。自信の数字で線を引く前に、迷う案件を人へ戻す方針も、選択肢に書いておく。これが、二つの検証を並べて見えた共通点です。
精度を上げるには、指示を工夫すればいい?
精度を上げる話になると、「魔法の指示文」を探したくなります。けれど指示を増やす前に、確かめたいことがあります。判断に必要な材料を落としていないか。その大切さがよく分かる外部の実験がありました。
bitnovusが公開している迷惑メール判定の実験では、正常・迷惑・フィッシングのメール計5,733通をJevで分類しています。最初の入力では、メール本文から文字は取り出せていても、リンクの本当の行き先やホスト名、返信先(Reply-To)、添付ファイル名といった情報が落ちていました。偽のeBay通知は、見た目の文面だけなら本物そっくりです。
著者は質問とモデルを固定したまま、落ちていた材料を戻しました。全件の分類正解率は93.62%から97.98%に上がり、偽のeBay通知を正常と判定していた102件のうち100件が、フィッシングへ戻ったと報告しています。
ただし、これは著者自身の報告です。すでに誤りを見たデータで手直しを探った実験であり、私たちが再現したものでもありません。それでも、問い合わせの仕分けに置き換えると示唆ははっきりしています。注文番号の欄、フォームの種類、添付の有無。人が判断に使っている材料が、AIの手前で消えていないかを先に確かめる価値はありそうです。
実務では、どこに置けばいい?
今回の結果と外部の報告を合わせると、最初の一歩は「消す」「返金する」「返信する」ではありません。担当候補のタグを付けることと、「要確認」を立てることです。
実務で試すなら、という運用案の説明図です。今回の検証で動かしたシステムではありません。候補のタグ付けや「要確認」の理由表示はコード側などで別に用意し、返信・交換・返金は人の確認後に行います。
担当候補:配送、返品・交換、支払い、商品のことなど。最終的に開くのは人です。
要確認と、その理由:用件が二つ以上ある/注文の特定に必要な情報が欠けている/AIへの命令やスクリプトが紛れ込んでいる/法的措置の予告がある。こうした理由も画面に残せれば、人は読む順番を決めやすくなります。
今回のJevの返答には、窓口・確率・confidenceはありますが、理由文はありません。「なぜ要確認なのか」を表示するなら、コードで拾った条件や追加の判定を使う、別の仕組みが必要です。
Jevが受け持つのは、文の意味から行き先を選ぶところまでです。注文番号が実在するかの照合、金額の計算、期限の比較は、コードと人の仕事として残します。公式も、正確な計算や日時の比較はコードへ任せるよう明記しています。
実際にこの形で動かしている例もあります。タレントクラウドは、問い合わせフォームの営業メール判定にJevを使い、2026年9月20日から本番で稼働していると報告しています。全件を同じ受信箱に届けたうえでタグだけを付け、判定に失敗したときもタグなしで届ける設計です。AIが止まっても、問い合わせは消えない。本番での精度はまだ測っていない、とも書いています。導入事例として、この慎重な置き方そのものが参考になります。
この数字は、どこまで信じていい?
今回の32通は、問い合わせも想定の行き先も規則も、同じ制作側が作った小さなストレステストです。実際の窓口担当者が付けた正解ではなく、日々届く問い合わせの自然な分布でもありません。だから23/24も16/24も、一般的な精度やほかのモデルとの優劣を示す数字ではありません。この条件で、どんな形の外れ方が起きたかを見るための記録として読んでください。規則側も、カナ表記や否定の扱いを足せば改善できる単純な比較相手です。
モデル:
jev-1.13.0(固定)測定日:2026年10月3日(日本時間)
呼び出し:開発用8通+評価用24通、計32回。各問い合わせ1回、再試行なし、32回すべて応答あり。
入力トークン:27,045
API費用:約0.00114ドル(USD0.00113589)。当日の掲載単価からの推計で、請求額との照合ではありません。
APIの往復時間:全32回の中央値171.5ミリ秒。通信を含むこの実行の観測値で、一般的な速度の保証ではありません。
では、何から試す?
評価用の24通で、作者案と違う担当候補を選んだものはありませんでした。拾えなかった一通は、手を挙げて人のところへ戻ってきました。小さな実験ですが、「どこまで任せるか」を考える材料としては十分に具体的です。
受信箱を丸ごと預けるのは、まだ違う。けれど、担当候補を付けて、迷うものは人へ戻す役なら、十分に試す価値があります。試すなら、個人情報の扱いを確かめたうえで、自分たちの問い合わせを数十通選び、担当者が先に行き先を付けてから流してみてください。見るべきは正解率の数字より、外れたものがどこへ行ったかです。