「48,200円」の「円」が、数字の中に潜り込んでいる。
AIに作ってもらった家計簿の画面だ。色も、カードの配置も、それらしくできている。けれど、いちばん大事な金額が読みづらい。惜しい。かなりできているだけに、余計に気になる。
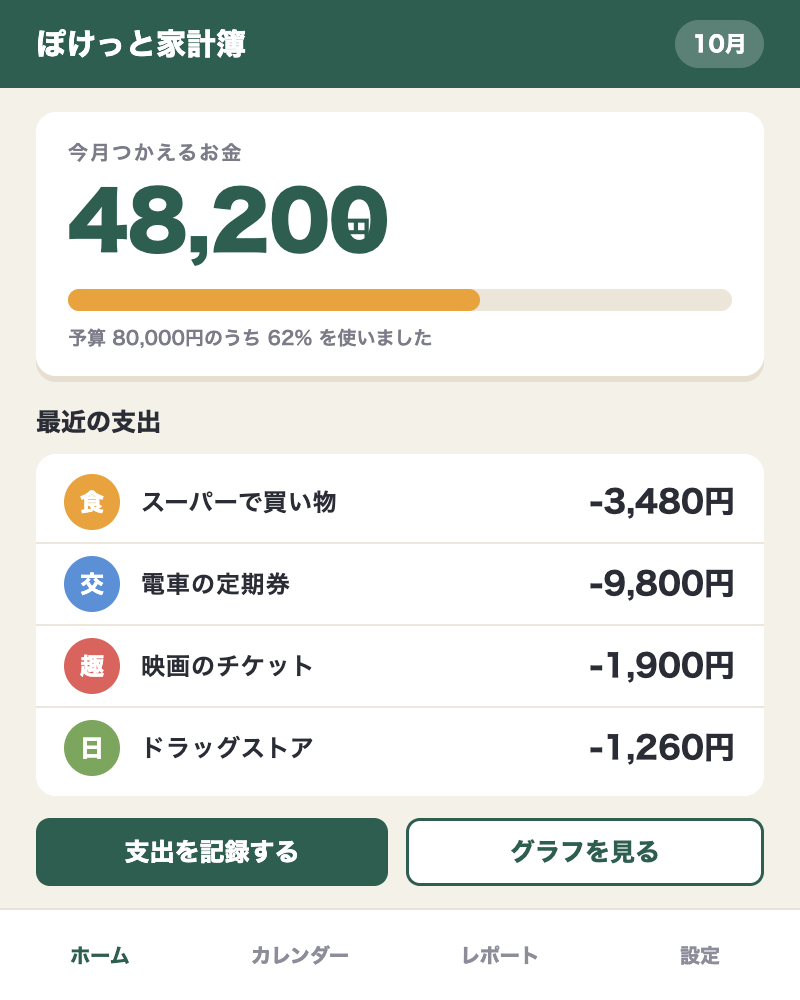
AIが作った架空の家計簿画面。円記号が数字に重なっている。
これは、RINKAKUのX検証ラボで実際に出てきた画面だ。自作の見本画像を渡し、6つのAIに、同じ見た目のWebページを作ってもらった。各3回、計18個。その中の、Claude Haiku 5.5による出力のひとつだった。
ここで「金額のところをいい感じに直して」と言いたくなる。でも、AIは自分が書いたコードを知っていても、それがブラウザーでどう表示されたかまで知っているとは限らない。
ならば、できた画面を撮って返そう。見本と見比べてもらったら、どこまで直るのか。
「どう見えているか」を、AIにも渡す
今回使ったのは、Claude CodeやCodexなど、パソコン上のファイルを読み書きしてコードを作る開発用のAIだ。調べものをするチャットではなく、HTMLとCSSを書き、Webページの形にしてもらう。
見本は、うちで作った架空のアプリ「ぽけっと家計簿」。幅800×高さ1000ピクセルの画像から、文字、色、配置を再現する課題にした。AIには画像を見て書くよう頼み、画像の色や座標をプログラムで測ったり、作ったページをブラウザーで開いて確認したりすることは禁止した。
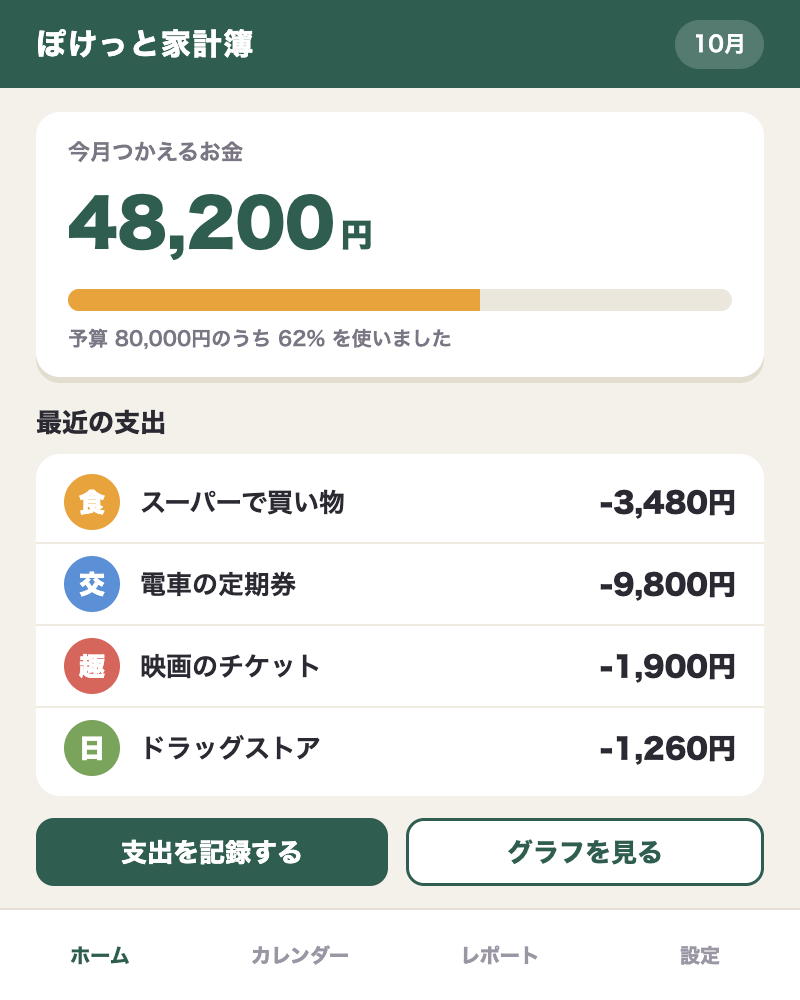
AIへ最初に渡した見本。自作の架空アプリ「ぽけっと家計簿」の画面。
つまり、最初の画面は「コードを書いたあと、まだ自分の出来上がりを見ていない」状態だ。これは今回の試験条件であって、開発用AIがブラウザーを使えない、という意味ではない。
次に、それぞれが作ったページをこちらで開いてスクショを撮り、同じAIへ返した。渡したのは、見本の画像、完成画面のスクショ、そして最初に書いたコードの3つ。追加で頼んだのは、見比べて、見本に近づけることだった。
target.png と mine.png を見比べて、index.html を直し、見た目をもっと target.png に近づけてください。
10/10の検証では、見本・できた画面・現在のコードを同じAIに渡し、1回だけ修正を依頼しました。普段の制作では、修正後もブラウザーで確認します。図:EDIFORCE。
人がここを何ピクセル動かす、と教えたわけではない。AI自身に、見本と現在のずれを見つけてもらった。
重なっていた「円」が、数字の横に戻った
冒頭のHaikuの画面は、こう直った。
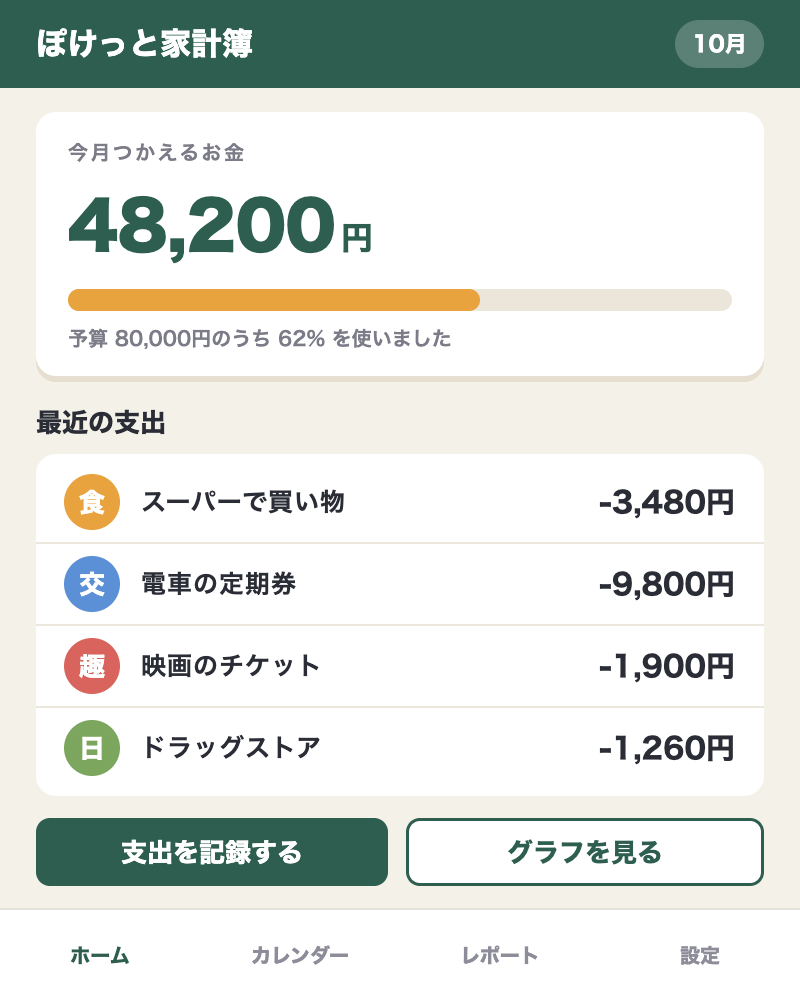
同じAIによる修正後。円記号が数字の右側に収まり、金額が読めるようになった。
「円」が数字から離れ、ちゃんと金額として読める。文字や余白も整い、見本に近い見た目になった。
これは地味だが、うれしい変化だ。「違うんだよな」と思っていた箇所を、細かなCSSの説明に訳さずに渡せたからだ。自分が作りたい画面を持っている人にとっては、このやり取りができるだけで、AIとの作業はずいぶん進めやすくなる。
ほかの出力にも変化があった。Claude Opus 5.5のある試行では、見本と同じ位置で色が近かったピクセルの割合が、92.9%から97.7%へ上昇。調べた24項目の文字の位置も、中心の平均ずれが5.7ピクセルから0.7ピクセルへ縮んだ。
修正前後を動かして比べたい人は、X検証ラボの比較動画も見てほしい。数字より先に、どこが変わったかが分かるはずだ。
18例中14例で改善。ただし「そっくり度」の点数ではない
18個の画面のうち、修正後に色の一致率が上がったのは14個だった。
AI:Claude Opus 5.5
今回、色の一致率が上がった出力:3個中3個
AI:Claude Haiku 5.5
今回、色の一致率が上がった出力:3個中3個
AI:GPT-6.1 sol
今回、色の一致率が上がった出力:3個中3個
AI:GPT-6 luna
今回、色の一致率が上がった出力:3個中3個
AI:Gemini 3.8 Flash
今回、色の一致率が上がった出力:3個中0個
AI:Grok 4.7
今回、色の一致率が上がった出力:3個中2個
6モデル×各3出力、見本は1種類。改善は色差が一定以下の画素の割合が上がったことを指し、使いやすさ・見た目の完成度・モデル全体の順位ではありません。10/10の保存実測。図:EDIFORCE。
ここでいう一致率は、見本と完成画面の同じ位置を1ピクセルずつ比べ、「色の差が一定以下だった場所」の割合だ。背景や余白も含む。97%だから人間の目にも97%そっくり、という意味ではないし、ボタンの使いやすさを測った数字でもない。
実際、最初のHaikuの画面は「円」が重なっているのに、この指標では94.5%だった。広い背景が合っていれば、小さくても困る間違いを数字が目立たなくしてしまう。だから、割合だけでなく、実物も並べて見る。
逆に、Geminiの3例はすべて少し下がった。修正を頼めば、必ずよくなるわけではなかった。
今回の課題は、見本1種類、各AI3回。AIごとに開発ツールや設定も異なる。また、画像を渡さずに言葉だけで修正する場合とは比較していない。スクショだけの効果や、モデル全体の優劣を決める試験ではない。
今回も、画像を返してから「円」が直るまで、人がCSSの修正箇所を指定する必要はなかった。
自分の画面で試すなら、見本と現状を一緒に
AIにページやアプリを作ってもらっていて、「ちょっと違う」をうまく伝えられないときは、まずスクショを撮ってみよう。
見本があるなら、その画像も添える。例えばClaude Codeなら、作業中のフォルダーへ見本と現在のスクショを保存し、その画像のパスと、修正したいHTMLファイルを伝えられる。画像をウィンドウへドラッグして渡す方法も、公式に案内されている。Claude Codeで画像を渡す方法
そのうえで、例えばこう頼めばよい。以下は、今回の依頼を普段の制作向けにした例だ。
1枚目が作りたい見た目、2枚目が今の画面です。見比べて、文字の重なり、余白、文字の大きさの違いを直してください。関係のない機能は変えないでください。修正後は画面を開いて確認し、確認できない場合はそのことを教えてください。
見本がなければ、今の画面に丸を付けて「この金額が重なっている」「このボタンが下へはみ出す」と示すだけでも、何に困っているかを共有しやすい。スクショに顧客名や連絡先などが映るときは、渡す前に隠しておきたい。
そして、直した画面は自分でも開く。今回のような単独のHTMLファイルなら、保存されたファイルをブラウザーで開いて確かめる。開発サーバーを使うアプリなら、AIにプレビューのURLを出してもらえばよい。
文字が読めるか。スマホの幅でも収まるか。押したいボタンを押せるか。今回のような見た目の比較と、アプリとして動くことの確認は別だ。
最初から完璧な指示を書かなければ、と身構える必要はない。作ってもらい、見て、気になるところを返す。その繰り返しで、自分が欲しかったものに近づけていけばいい。
「もっときれいに」と言葉を重ねる前に、今、何が見えているかを一枚渡す。AIにも出来上がりを見てもらう。今回いちばん持ち帰りたいのは、この単純なやり方だ。
検証について
検証は2026年10月10日、EDIFORCEのX検証ラボで実施。Claude Code 2.1.291、Codex 0.159.2、Antigravity 1.3.3、Grok Build 1.0.46を使用した。モデル名は表のとおり。モデルごとに初回3出力を作り、各出力に1回ずつ修正を依頼した。
初回にCodexで動かした2モデル(GPT-6.1 solとGPT-6 luna)の計6試行のうち3試行では、指定フォルダー外のファイル名を一覧する動作があった。見本のHTML自体を開いた記録はないが、修正試行では念のため見本HTMLや他の出力を作業用の場所から退避した。前後で隔離条件も変わっているため、画像を追加した効果だけを測れたとはしない。個々の修正前後を見せる検証として読んでほしい。
掲載画像は実出力。見本は自作の架空UIで、実在の家計簿アプリを複製したものではない。動画は同じ検証記録を編集したものだ。