AIに問い合わせを読ませる、と聞くと、返事の文章を作ってもらう場面を思い浮かべるかもしれない。でも、その前に済ませたい仕事がある。これは請求の相談なのか、システムの不具合なのか。それとも、営業へ渡したほうがよい話なのか。
長い説明はいらない。いま欲しいのは、次の担当を一つ選ぶことだ。こうした小さな判断を返すために作られたAIが、判断モデルと呼ばれている。
今回、手元のMacで試したのはCloudflareのClef Flashだ。TypeSafe AIのJevも、同じように「選ぶ判断」を担うAIとして知られている。まずはJevを例に、判断AIが何をするものなのかを見てから、Clef Flashで試した結果へ進みたい。
Jevは、文章ではなく「選んだ答え」を返す
JevはTypeSafe AIが提供する判断モデルだ。状況を説明する文と、答えてほしい質問を渡すと、決められた形の答えが返ってくる。例えば、「この問い合わせを、請求・技術・営業のどこへ回すか」。行き先の候補も、何をその担当へ回したいかという説明も、使う側が用意する。
答えは「技術」といった選択肢と、候補ごとの確率。ほかにも「急ぎか」というはい・いいえの質問や、「影響なし、小さい、大きい、致命的」のような段階に沿った評価を扱える。返信文や説得力のある理由を、自由な文章で書いてくれるAIではない。TypeSafeの公式Introduction
文章を読む人の代わりになるというより、次に何をするかを決める処理の中へ、言葉を読む力を差し込む。担当を選んだ後に誰が対応するか、返金を実行するか、どんな返事を送るかは、別の処理として残る。
使いどころは、返事を書く前の段取り
ネットショップの窓口を考えてみる。「二重に引き落とされた」なら請求へ、「画面が真っ白で動かない」なら技術へ。問い合わせの用件を読んで担当候補を付けられれば、人が返事を考える前の下準備に使える。急ぎかどうかも一緒に尋ねれば、見る順番を考える材料になる。
資料を探す場面にも似た使い道がある。検索で見つかった文章が、いまの質問に関係するかを評価して、回答を作るAIへ渡す資料を選ぶ。あるいは、依頼の内容に応じて、どのAIや道具へ回すかを選ぶ。TypeSafeの公式資料も、問い合わせの分類、検索結果の並べ替え、モデルの振り分けなどを用途の例に挙げている。これは提供元が示す使い方で、今回すべてを検証したわけではない。公式のExample use cases
「何でも任せるAI」から考えなくてもよい。毎回、人が本文を読んで決めている小さな分かれ道があれば、そこを切り出して試せるのが、この種類のAIの面白さだ。
今回は、JevではなくClef Flashを選んだ
Jevの公式Quick startには、APIキーを用意し、TypeSafeのAPIへ文と質問を送る利用手順がある。APIは、プログラムからサービスへ依頼を渡す窓口だ。この方法なら、手元でモデルを読み込まずに問い合わせられる。Jevの公式Quick start
今回見たかったのは、同じような「選ぶAI」を、外部の推論APIへ本文を渡さず、自分たちのMacで動かせるかだった。そこで主役にしたのが、モデルを構成する重みが公開されているClef Flashだ。Cloudflareの9B、つまり約90億パラメータ規模の判断モデルで、公開ファイルを使って実行できる。Clef Flashの公式モデルカード
ローカルモデルを動かす道具のOllamaもClef Flashに対応している。JevのAPIに沿った文と質問の形式で、Mac内のOllamaへ依頼を渡せる。今回使ったのはOllama 0.35.1だった。OllamaのClef Flash掲載情報
Jevより性能がよいから選んだ、という話ではない。このテストではJevを呼び出していないので、Jevとの精度や速さの実測比較もない。質問の形式が似ていることと、同じ結果になることも別だ。
手元で動けば、問い合わせの下準備を近くに置ける
問い合わせには、名前や注文の事情、支払いの話が入りやすい。ローカル実行なら、そうした本文を外部の推論サービスへ送らずに担当候補を付ける構成を選べる。同じ例文を何度か流し、候補の説明を変えて確かめる作業も、自分たちの環境で進められる。
一方で、モデルの準備や更新、Macの計算資源、保存するログの管理は自分たちに残る。手元で動くというだけで、個人情報の扱いがすべて片づくわけではない。今回は機密の問い合わせを入れず、架空の文章で、判断が返るところを確かめた。
手元の機械へ置けるのは、完成した問い合わせ窓口ではない。まずは、返事を書く人の手前で働く小さな仕分け係。そのくらいの大きさから試した。
日本語の問い合わせ16件で、行き先を見てみる
RINKAKU動画班のテストでは、日本語の問い合わせ16件を使った。本文はClaudeエリスが検証用に作った架空のもの。各文を作る時に、想定する担当も一緒に付けている。実際のお客さまから届いたメールでも、別の担当者が独立して採点した正解データでもない。
モデルへ渡したのは本文と、固定した3問だ。「この問い合わせは急ぎですか?」「どの担当が対応すべきですか?」「お客さまへの影響はどれくらい深刻ですか?」。担当の説明は、請求が「支払い・請求・返金」、技術が「障害・エラー・設定」、営業が「プラン・契約の相談」。想定した担当名は入力へ含めず、本文から選ばせた。
目的は、こうした日本語の文から担当候補を返せるか、そして候補に付く数字がどう出るかを見ること。急ぎと深刻さには採点用の正解を用意していないため、ここでは担当の結果を中心に読む。
Clef Flash 9BをM4 MaxのMac上で動かした、2026年10月5日の保存記録を記事用に再集計した。同じ16件を3周計測しているが、回答を保存したのは各件の1周目だけ。以下はその16回答の結果で、新たに推論を実行し直した報告ではない。
Clef Flashの行き先は、16件とも想定と一致した
請求、技術、営業の選択は、16件すべてで作者が想定した担当と一致した。読み込みと質問の受け渡しができるだけでなく、今回用意した文では、期待した仕分けまで返ってきた。これはうれしい結果だ。ただし、実際の窓口で100%正しく判断できるという意味ではない。
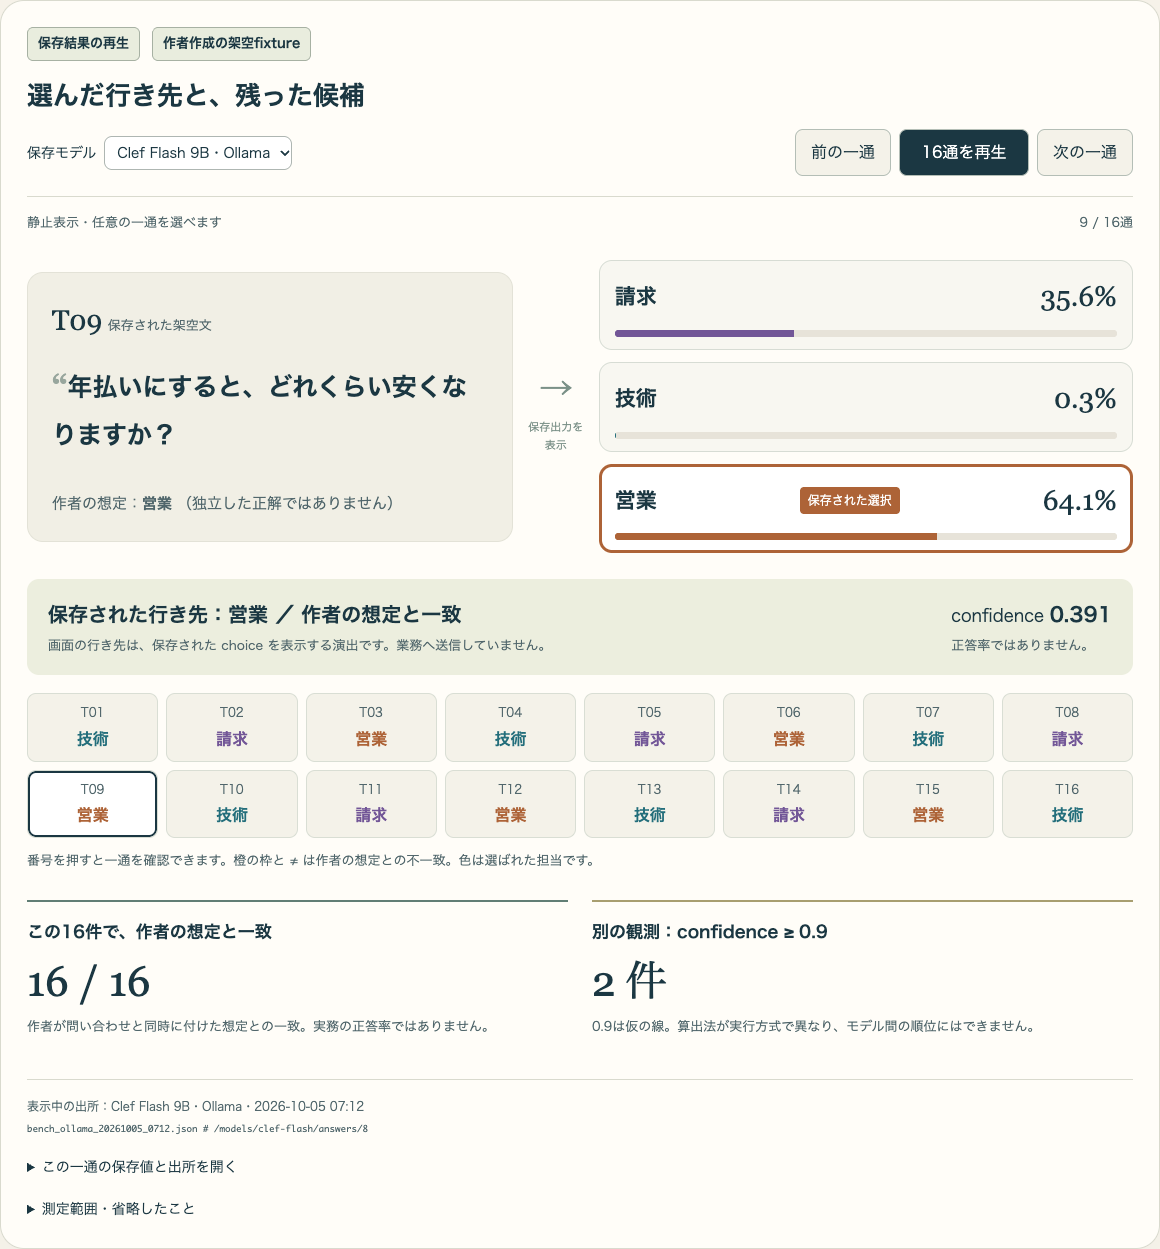
年払いの割引を尋ねる一通では、答えと数字を一緒に見られる。
年払いにすると、どれくらい安くなりますか?
作者の想定は営業。Clef Flashも営業を選び、候補へ割り当てた確率は営業64.1%、請求35.6%、技術0.3%だった。「年払い」は支払いの話にも読めるので、請求側にも値が残っている。ただし、それがモデルの判断理由だと説明されたわけではなく、出力を見た制作側の読みだ。
この回答のconfidenceは約0.39だった。confidenceは「自信」と訳されることがあるが、今回のOllamaでは、候補の確率がどれほど集中しているかをまとめた0〜1の指標だ。「この答えが39%の確率で正しい」という意味ではない。営業へ割り当てた64.1%も、実務でそれだけ当たると測った正答率ではない。Ollamaのconfidenceの説明

別の一通では、在庫の数が注文後も減らず、売りすぎを心配している。Clef Flashは想定どおり技術を選んだが、confidenceは約0.33だった。行き先が一致することと、ほかの候補をほぼ捨てることは、同じではない。
仮に0.9で線を引くと、Clef Flashがその線以上だったのは2件。残り14件は0.9未満だったが、今回の想定とはすべて一致していた。低い数字をそのまま不正解扱いすることも、高い数字だけを見て処理を任せることも、この記録からはできない。
参考として、同じ文と質問を渡したほかの3モデルの保存結果も並べておく。ただし、confidenceの計算方法は実行方式によって違う。右の列は、モデルの自信を同じ物差しで順位付けしたものではない。
| モデル・実行方式 | 想定した担当と一致 | confidence 0.9以上 |
|---|---|---|
| Clef Flash 9B・Ollama | 16/16 | 2件 |
| Tev1 4B・Ollama | 16/16 | 4件 |
| Nimble 9B・Ollama | 15/16 | 6件 |
| Decider 2B・MLX | 13/16 | 9件 |
ここにも、単純な順位を付けられない理由がある。Deciderの担当confidenceは、最大の候補確率から計算する。一方、Ollama 0.35.1は全候補への散らばりを使う。同じ名前でも計算方法が違うため、9件と2件の差をモデルの賢さや慎重さの差だけにしない。今回のDeciderの実装、Ollama 0.35.1の実装

Jevの公式資料も、confidenceは回答の確率分布から計算する指標と説明し、どこで確認へ回すかは、自分の用途のデータで試すよう求めている。Jevや別モデル向けに決めた線を、Clef Flashへそのまま持ち込めばよいわけではない。TypeSafeのConfidence
「返信するAI」より手前にも、役に立つ場所がある
今回いちばん面白かったのは、AIに長い文章を書かせなくても、仕事へつなぐ入口が見えたことだ。請求か、技術か、営業か。人が対応を始める前の小さな判断を、手元で返せた。
もちろん、実務への次の一歩は別に確かめたい。用件が二つある文や、事情の足りない文も含め、担当者が独立して行き先を付けた別の問い合わせで試す。最初は担当候補のタグを付け、人の判断と照らすところから。今回、受信から送信まで任せられる窓口を完成させたわけではない。
それでも、「AIに何を書かせよう」だけでなく、「人が仕事に入るまでの、どの判断を手伝ってもらおう」と考えられる。Jevが示す判断AIの使い道を、Clef Flashなら自分たちの機械でも試せる。今回の16件は、その仕分け係を少し身近にした。